Une approche positionnelle de Collatz
La théorie Une application
1. Principe de fonctionnement
Les suites de Collatz dont il est question ici sont compressées. Chaque étape est définie par :
Leur type $t$ correspond au nombre de termes impairs intermédiaires, c'est-à-dire à l'exclusion du terme initial $n_0$ et du 1 final. Dans ce document, $n_0$ est implicitement impair. Exemples :
type 2 : $9101,13652,6826,{\color{#FF0000}3413},5120,2560,1280,640,320,160,80,40,20,10,{\color{#FF0000}5},8,4,2,1$
type 1 : $29125,43688,21844,10922,{\color{#FF0000}5461},8192,4096,2048,1024,512,256,128,64,32,16,8,4,2,1$
type 0 : $87381,131072,65536,32768,16384,8192,4096,2048,1024,512,256,128,64,32,16,8,4,2,1$
Les positions impaires déterminent le terme initial $\mathbf{n_0}$
Soit la suite de longueur $L$ (son nombre total de termes) et de type $t$ dont les termes impairs intermédiaires figurent aux positions $p_1 < p_2 < \cdots < p_t$ (leur distance de $n_0$) ; la liste $S$ qui les contient ; et $p1=L-1$, la position du 1 final. En développant les transformations successives de Collatz, on obtient :
Autrement dit, une fois connue la position de chacun des $t$ termes impairs intermédiaires de sa suite, ainsi que celle du 1 final, $n_0$ est entièrement déterminé.
      # Somme cumulée (position des termes impairs intermédiaires dans la suite de n)
      def sommeCum(n):
        S = []
        p = 1

        while p != n:
          n = 3*n + p
          p = n & -n   # Plus grande puissance de 2 qui divise n
          S.append(p.bit_length() - 1)  # Exposant de 2, équivalent de log2(p)

        p1 = S.pop()   # Position du 1 final
        t = len(S)     # type

        return S, p1, t

      #Exemple : sommeCum(117) → [5, 6, 8, 11], 15, 4

      def uneFonction(n):
        S, p1, t = sommeCum(n)
        print((2**p1 - (3**t + sum(2**S[k] * 3**(t-k-1) for k in range(t)))) // 3**(t+1))

      #Exemple : uneFonction(117) → 117
La somme peut être avantageusement remplacée par sa forme de Horner
Proposée par l'IA, cette méthode présente l'avantage d'être itérative : chaque terme est calculé à partir du précédent, sans avoir à recalculer les puissances de 3 de la somme originelle. Elle remplace désormais la formule (1) datant de 2015.
        S, p1, t = sommeCum(n)

        A = 1
        for s in S:
          A = 3*A + 2**s

        n0 = (2**p1 - A) // 3**(t + 1)
Les deux versions de cette formule n'utilisent jamais la valeur des termes impairs intermédiaires, mais uniquement leur position respective par rapport à $n_0$. Le concept de suite anonyme permet d'illustrer ce fait.
2. La suite anonyme
Considérons un segment de droite et positionnons dessus quelques points dont la distance à l'origine est un entier. On obtient ce qui ressemble à une suite de Collatz sans en être une, et le calcul de $n_0$ s'applique aussi bien, même s'il est virtuel. À condition bien sûr que le point représentant le 1 final, $p1$, soit positionné au bon endroit, sinon $n_0$ ne sera pas entier.
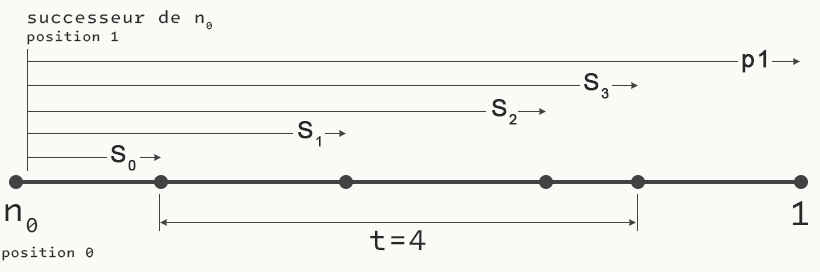
La position est comptée à partir du successeur de $n_0$, lui-même à la position 0.
Une telle suite est dite anonyme parce qu'on ne connaît la valeur d'aucun de ses termes : seule compte la position de chacun d'eux. On peut ainsi placer arbitrairement des points $S_0,S_1,\ldots,S_{t-1}$ à des positions entières croissantes. Ils constituent le squelette d'une suite possible, sans que nous sachions encore quels nombres occuperont ces positions (ni n'avons besoin de le savoir). La formule (2) — et en particulier $A_t$ — montre que ces positions permettent de calculer le premier terme de la suite anonyme. Par application de la fonction de Collatz nous obtiendrons ensuite le valeur numérique des autres points.
Les positions intermédiaires ne suffisent cependant pas au calcul de $n_0$, car il manque une information essentielle : la position $p1$. Rien n'impose que le 1 final succède au dernier point, $S_{t-1}$ (dernier terme impair intermédiaire) : d'autres peuvent se trouver au-delà, et la suite peut être beaucoup plus longue que la portion représentée. Aussi longtemps que la position de 1 reste inconnue, $n_0$ est indéterminé (affirmation démentie plus loin). Pour éviter ce scénario nous poserons que la suite anonyme représente une suite complète réduite à sa structure positionnelle : où sont les impairs, et où se trouve le 1 final ? Dans cette approche, les notions traditionnelles d'altitude et de durée de vol (entre autres) ne constituent plus des données pertinentes.
		import random

		S = []		# Si non défini, générer S aléatoirement
		if not S:
			S = sorted(random.sample(range(1, 21), random.randint(1, 8)))
		t = len(S)

		# Le 1 final se trouve au minimum 4 positions après
		# son prédécesseur impair (le plus souvent 5)
		p1 = S[-1] + 4
		d = 3**(t + 1)

		A = 1
		for s in S:
			A = 3*A + 2**s

		# Calcul de p1
		cible = A % d
		val = pow(2, p1, d)
		while val != cible:
			val = (val * 2) % d
			p1 += 1

		n0 = (2**p1 - A) // d

		print(f"S: {S}, t: {t}, p1: {p1}, n0: {n0}")
Vérification expérimentale
Afin de vérifier cette construction, 100 000 listes $S$ de une à huit positions entières strictement croissantes ont été générées aléatoirement. Pour chacune d'elles, $A_t$ a été calculé puis $p1$ recherché à partir de la position $S_{t-1}+4$ jusqu'à satisfaire
$$2^{p1} \equiv A_t \pmod{3^{t+1}}$$
L'entier $n_0=\dfrac{2^{p1}-A_t}{3^{t+1}}$ a ensuite été calculé, puis sa suite analysée par sommeCum($n_0$).
Dans les 100 000 cas, sommeCum($n_0$) a restitué exactement la liste $S$, la valeur de $p1$ et le type $t$ ayant servi à construire $n_0$. Aucun contre-exemple n'a été rencontré. Ce résultat constitue une vérification expérimentale de la méthode, et non une démonstration de sa validité pour toute liste $S$ de positions.
3. Les suites partiellement isomorphes
Cette recherche sur les suites isomorphes à $n_0$ sur les $t$ termes intermédiaires (d'où le qualificatif de partielles) date également de la période 2015-2018.
Partant de $S=[a,b,c,...]$, quelles valeurs de $n_0$ autres que celle calculée ont les $t$ termes intermédiaires de leur suite positionnés de la même manière ?
$\large \Delta =2^{S_{t-1}+1} \qquad \small (S_{t-1}$ est le dernier terme de $S)$
$\large m=n_0 \, \text{mod} \, \Delta$
Le premier terme $i_0$ de toutes les suites partiellement isomorphes à celle de $n_0$ est :
$\large i_{0,k}=m+k \, \Delta, \quad \small k \ge 0$
Prenons un exemple : $S=[4,5,6] → \,t=3,n_0=805$. On a
$\Delta=2^7=128$
$m=805 \; \text{mod} \; 128=37$
$i_0 = 37 + 128 \times \lbrace 0,1,2,... \rbrace= 37,165,293,421,549,677,805,933,1061,...$
$37, 56, 28, 14, {\color{#FF0000}7, 11, 17}, 26, 13, 20, 10, 5, 8, 4, 2,
1$
$165, 248, 124, 62, {\color{#FF0000}31, 47, 71}, 107, 161, 242,...$
$293, 440, 220, 110, {\color{#FF0000}55, 83, 125}, 188, 94, 47,...$
etc.
La structure positionnelle de la suite anonyme est présente dans une infinité de suites.
		import random

		S = []		# Si non défini, générer S aléatoirement
		if not S:
			S = sorted(random.sample(range(1, 21), random.randint(1, 8)))
		t = len(S)

		# Le 1 final se trouve au minimum 4 positions après
		# son prédécesseur impair (5 en l'occurrence)
		p1 = S[-1] + 4
		d = 3**(t + 1)

		A = 1
		for s in S:
			A = 3*A + 2**s

		# Calcul de p1
		cible = A % d
		val = pow(2, p1, d)
		while val != cible:
			val = (val * 2) % d
			p1 += 1

		n0 = (2**p1 - A) // d

		print(f"S: {S}, t: {t}, p1: {p1}, n0: {n0}")

		# -------------------------------
		# Suites partiellement isomorphes
		# -------------------------------

		delta = 2**(S[-1] + 1)
		m = n0 % delta

		# Exclure un éventuel prédécesseur impair direct de 1 (donc de type 0)
		x = 3*m + 1
		if x & (x - 1) == 0:   # Si vrai, x est une puissance de 2
			m += delta

		i = []
		for k in range(10):
			i.append(m + k * delta)

		print(f'\n{i}')
3.1 Construction directe d'une famille de suites partiellement isomorphes
L'algorithme précédent permet de construire un entier $n_0$ dont les $t$ termes impairs intermédiaires occupent les positions définies par $S$, et dont la suite atteint ensuite 1 sans rencontrer d'autres termes impairs. Cette dernière condition peut toutefois conduire à un entier $n_0$ extrêmement grand. Il faut en effet rechercher la position $p1$ telle que $2^{p1}\equiv A_t\pmod{3^{t+1}}$. Or, si l'on souhaite seulement construire des suites partiellement isomorphes, cette contrainte est inutile. Il suffit que leurs $t$ premiers termes impairs, hors $n_0\,$, occupent les positions de $S$. Le reste de la suite peut se poursuivre librement jusqu'à 1.
Nous savons que ces suites appartiennent à une même classe de congruence
: $n_k=m+k\,\Delta$,
avec $\Delta=2^{S_{t-1}+1}$. Reste à
déterminer directement $m$ sans construire au préalable un entier $n_0$
gigantesque.
La formule utilisée pour reconstruire $n_0$ est $3^{t+1}\,n_0+A_t=2^{p1}$, où $A_t$ se calcule par récurrence :$$A_0=1,\quad A_{k+1}=3A_k+2^{S_k}$$
Comme $p1>S_{t-1}$, le terme $2^{p1}$ est divisible par $\Delta$. On en déduit que $$3^{t+1}n_0+A_t\equiv0\pmod{\Delta}$$
Puisque 3 et $\Delta$ sont premiers entre eux, $3^{t+1}$ possède un inverse modulo $\Delta$. Nous obtenons donc directement $$\boxed{m\equiv-A_t\,3^{-(t+1)}\pmod{\Delta}}$$
Notez que $3^{-(t+1)}$ désigne un inverse modulaire, et non une puissance négative au sens ordinaire. En Python, cette opération s'effectue avec pow(3, -(t+1), delta). Le précédent algorithme devient :
		import random

		S = []		# Si non défini, générer S aléatoirement
		if not S:
			S = sorted(random.sample(range(1, 31), random.randint(1, 10)))
		t = len(S)

		delta = 2**(S[-1] + 1)

		A = 1
		for s in S:
			A = 3*A + 2**s

		m = (-A * pow(3, -(t+1), delta)) % delta

		i = [m + k*delta for k in range(10)]

		# Exclure un éventuel prédécesseur impair direct de 1 (donc de type 0)
		x = 3*i[0] + 1
		if x & (x - 1) == 0:   # Si vrai, x est une puissance de 2
			i.pop(0)

		print(f"S: {S}, t: {t}")
		print("\nn0 :", ", ".join(map(str, i)))
Cette méthode évite entièrement la recherche de $p1$ et le calcul préalable d'un entier $n_0$ potentiellement très grand.
Exemple :
1ère version
S: [2, 4, 6, 8, 12, 14, 15, 19], t: 8, p1: 921, n0:
900605747140352704541626446876791248808993513176897279783526541162796100671353474569114949566071876773005900977614529430005973031839598418790665910490482678122300016153538798170704579389851598806874461081681377988425216343200140794576779338956937930797531932332959844484097
[476161, 1524737, 2573313, 3621889, 4670465, 5719041, 6767617, 7816193,
8864769, 9913345]
2ème version
S: [2, 4, 6, 8, 12, 14, 15, 19], t: 8
n0 : 476161, 1524737,
2573313, 3621889, 4670465, 5719041, 6767617, 7816193, 8864769, 9913345
Relation entre les premier et dernier termes de telles suites
Dans une famille de suites partiellement isomorphes définies par les positions $S$ de leurs $t$ termes impairs intermédiaires,
- les premiers termes $n_0$ forment une progression arithmétique de raison $2^{S_{t-1}+1}$,
- les termes impairs situés à la dernière position $S_{t-1}\,$ — appelons-les $F$ — forment également une progression arithmétique, mais de raison $2\cdot3^t$.
Ainsi, lorsqu'on augmente de $2^{S_{t-1}+1}$ le premier terme d'une suite, son terme impair à la position $S_{t-1}$ augmente pour sa part de $2\cdot3^t$. En notant $n_{0,0}$ le premier terme de la suite de référence et $F_0$ son terme impair à la position $S_{t-1}\,$, on obtient, pour tout entier $\small k\geq 0$ : $$n_{0,k}=n_{0,0}+k \cdot 2^{S_{t-1}+1} \:\Longrightarrow\: F_k=F_0+k\cdot 2\cdot3^t$$
Exemple : $S=[2,5,6,7,9],t=5$
L'algorithme ci-dessus renvoie
$n_0: 593, 1617, 2641, 3665, 4689, 5713, 6737, 7761, 8785, 9809$
$2^{S_{t-1}+1}=2^{10}=1024$
$2\cdot3^t=2 \cdot 3^5=486$
$\begin{aligned} k=0 &: \quad n_{0,0}=593+0\times1024=593, && F_0=283+0\times486=283\\ k=1 &: \quad n_{0,1}=593+1\times1024=1617, && F_1=283+1\times486=769\\ k=2 &: \quad n_{0,2}=593+2\times1024=2641, && F_2=283+2\times486=1255 \end{aligned}$
$593, 890, {\color{#FF0000}445}, 668, 334, {\color{#FF0000}167},
{\color{#FF0000}251}, {\color{#FF0000}377}, 566, {\color{#FF0000}283},
...$
$1617, 2426, {\color{#FF0000}1213}, 1820, 910, {\color{#FF0000}455},
{\color{#FF0000}683}, {\color{#FF0000}1025}, 1538, {\color{#FF0000}769},
...$
$2641, 3962, {\color{#FF0000}1981}, 2972, 1486, {\color{#FF0000}743},
{\color{#FF0000}1115}, {\color{#FF0000}1673}, 2510, {\color{#FF0000}1255},
...$
Un petit utilitaire
Les scripts Python qui précèdent requièrent un affichage des suites compressées offrant une distinction nette entre les termes impairs intermédiaires et tous les autres termes. Le script suivant les affiche en gras rouge :
		# Suite compressée avec distinction des termes impairs intermédiaires
		def suiteColoree(n, indices=1, couleurs=1):
			termes = [str(n)]
			p = 0

			while n > 1:
				n = (3*n + 1)//2 if n % 2 else n//2
				p += 1
				s = str(n)

				if n > 1 and n % 2:
					indice = f"•{p}" if indices else ""

					if couleurs:
						s = f"\033[1;91m{s}\033[22;33m{indice}\033[0m"
					else:
						s += indice

				termes.append(s)

			print(", ".join(termes))
			return None

		# Exemples. TI → termes impaires intermédiaires
		suiteColoree(37)			# Affichera les TI en rouge et les indices en jaune
		suiteColoree(37, 0)		# Affichera les TI en rouge, mais pas les indices
		suiteColoree(37, 1, 0)	# Affichera les indices non colorés
		suiteColoree(37, 0, 0)	# Affichera la suite simple, sans couleurs
4. Distribution statistique des suites de Collatz par longueur et type
Pour une longueur $L$ donnée, l'ensemble des termes initiaux $n_0$ peut être réparti selon le type $t$ de leur suite, indiqué dans la colonne de gauche. Le tableau suivant donne cette répartition pour $L=21$ :
| 8 | [43] |
|---|---|
| 7 | [131, 133] |
| 6 | [397, 405, 433, 435, 441, 475] |
| 5 | [1237, 1251, 1285, 1301, 1313, 1325, 1339, 1425, 1427, 1431, 1433] |
| 4 | [3861, 3925, 3939, 3941, 3981, 4017, 4019, 4043, 4277, 4293, 4297, 4301] |
| 3 | [11605, 11829, 12053, 12131, 12133, 12853, 12885, 12893, 12913, 12931] |
| 2 | [36181, 36405, 38677, 38741, 38797, 38833, 38835] |
| 1 | [116053, 116501] |
| 0 | [349525] |
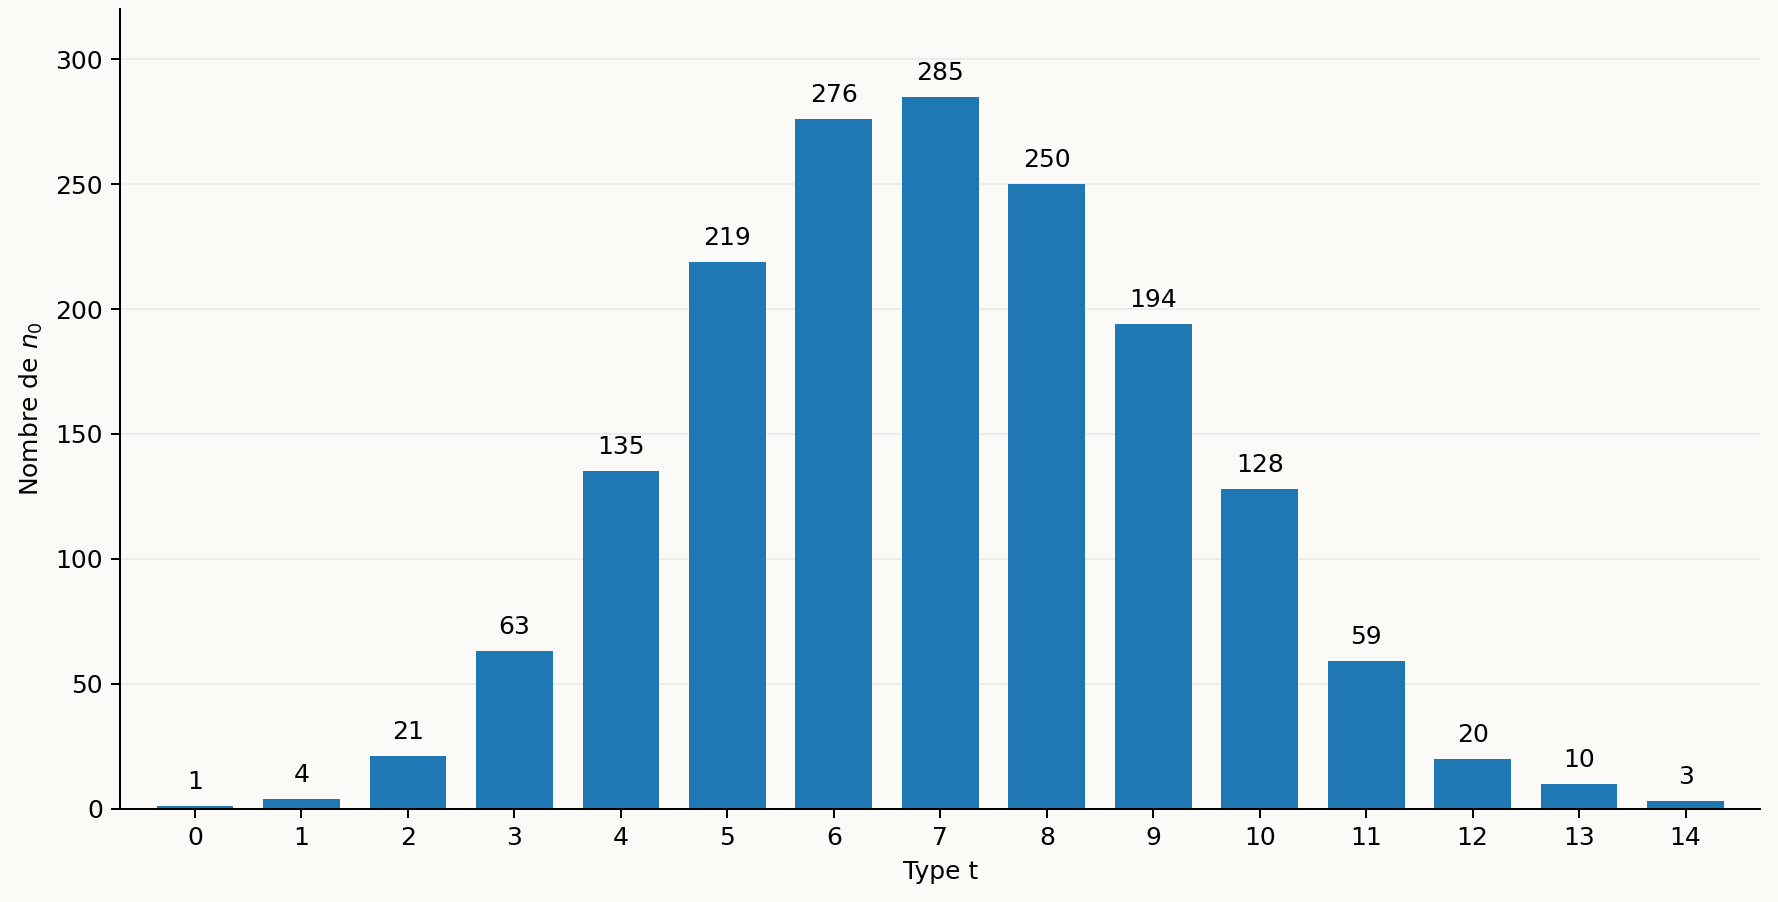
Distribution du nombre de suites compressées pour $L=33$ et $t=0,...,14$
Si l'on ne conserve que le nombre de suites pour chaque type, on obtient une distribution en forme de cloche, qui devient de plus en plus régulière lorsque $L$ augmente :
Valeur respective de $t_{min}$ et $t_{max}$
Si l'on reprend la formule (1) au début de cette page et qu'on donne à $t$ la valeur 0, on trouve $n_0=\dfrac{2^{L-1}-1}{3}$.
On voit que $n_0$ n'est un entier strictement positif que lorsque $L$ est impair :
Les calculs effectués jusqu’à présent suggèrent que le sommet de la distribution se situe autour de
Cette observation conduit à l’estimation de $t_{max}$ :

5. Une application
Accessible à cette adrresse, elle traite de ce que nous pourrions appeler un problème inverse. Habituellement, nous choisissons un entier impair de départ puis nous calculons sa suite de Collatz. Ici nous faisons l'inverse : nous fixons d'abord la longueur et le type de la suite, puis nous cherchons tous les entiers impairs dont la suite possède exactement ces caractéristiques.
L'approche naïve devient vite impraticable
Elle consiste à essayer toutes les combinaisons possibles de positions des termes impairs (nommées suites candidates). Or, leur nombre vaut $\mathbf{\binom{L-5}{t}}$[1] et peut très rapidement devenir gigantesque, même pour des valeurs de $L$ et $t$ encore modestes. Cette méthode fonctionne, mais elle gaspille énormément de temps à développer des branches qui ne pourront jamais conduire à un entier $n_0$. Et le plus ennuyeux est qu'elle finit très facilement par geler le PC qui la met en œuvre.
-
[1]. $\mathbf{\binom{L-5}{t}}$ parce que $n_0$ et les 4 (au minimum)
derniers termes de la suite compressée que sont $8, 4, 2, 1$ ne seront
jamais utilisés comme position pour un terme impair intermédiaire. Il
est donc parfaitement inutile d'en tenir compte dans la longueur de la
suite et d'augmenter ce faisant le nombre de combinaisons à étudier.
Neuf ans après la création de cette application, une nouvelle méthode de calcul proposée par l'IA a permis d’optimiser radicalement l’algorithme initial : au lieu d'examiner systématiquement toutes les combinaisons, la nouvelle méthode élimine au fur et à mesure les branches qui ne peuvent pas conduire à une solution.
L'idée clé : éliminer les mauvaises branches avant la fin
La formule (2) impose que son numérateur soit divisible par $3^{t+1}$. Plutôt que d'attendre d'avoir traité tous les ensembles de positions, l'algorithme les construit de la dernière vers la première et teste progressivement des congruences modulo 3, puis 9, 27, 81, etc.
Dès qu'une branche ne satisfait plus la congruence requise, elle est abandonnée. Il est donc inutile d'examiner toutes les positions qui auraient pu la prolonger.
Dans cette relation, $Q_r$ représente la partie déjà construite de la somme correspondant aux $r$ dernières positions impaires :
Le premier filtre, modulo 3, impose déjà une contrainte de parité sur la dernière position. Les filtres suivants deviennent de plus en plus sévères. Le calcul explore donc un arbre, mais en coupe très tôt la plupart des branches impossibles.
Pourquoi le calcul peut être interrompu et repris
L'application exécute la recherche dans un Web Worker afin de ne pas bloquer l'interface. Le parcours de l'arbre est conservé sous forme d'une pile explicite. Lorsque la limite « Max résultats » est atteinte, l'état exact du parcours est mémorisé.
Si l'on augmente ensuite cette limite, la recherche reprend au point précis où elle s'était arrêtée : les résultats déjà trouvés ne sont ni recalculés ni effacés.
Ainsi, une recherche très importante peut être menée par étapes : 1 000 résultats max, puis 5 000, puis 10 000, etc. Lorsque le mot max en rouge disparaît de la mention n suites — dans la barre de titre de la fenêtre de résultats — , l'exploration est exhaustive et le nombre affiché est le nombre réel de suites correspondant au couple $(L,t)$.
5.1 Utilisation de l'application
En dehors de générer la liste (exhaustive ou non) des suites compressées de Collatz dont la longueur et le type sont donnés, on peut rechercher des $n_0$ dont la suite compressée est de même longueur et type que celle de l'entier $m$ impair fourni :
-
Dans le champ
Longueur
tapez $m$ précédé d'un #, comme #123. Après validation, l'application le
remplacera par la longueur de sa suite et injectera son type dans le
champ suivant. Le nombre de suites candidates sera indiqué en rouge en
dessous. Validez de nouveau si vous désirez poursuivre.
Bien sûr, $m$ figurera dans la liste finale des $n_0$.
Interactions
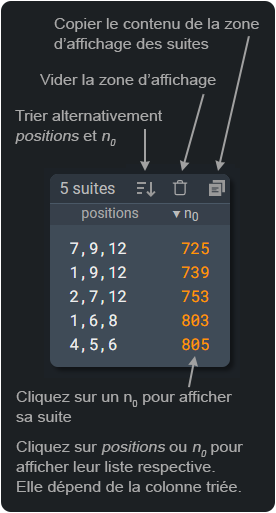
La zone d'affichage est le conteneur dans lequel les données demandées s'affichent. Elle se trouve tout en haut de la page du navigateur mais n'apparaît qu'à sa première utilisation.
Sécurité
Pour éviter de vous retrouver avec des dizaines de milliers de résultats que votre navigateur devra gérer et afficher, ce qui risque de devenir probématique si vous disposez de peu de RAM, cochez la case "Nbr de résultats" avant de cliquer sur Ok. Par exemple, avec $L=65$ et $t=14$ le nombre de suites candidates est de 17 345 898 649 800, et le nombre de résultats de 1 942 132 suites.
Ces chiffres tiennent lieu d'avertissement, n'est-ce pas ? Décochez la case en question avant de cliquer à nouveau sur Ok. Les 100 premiers résultats seulement seront affichés, nombre que vous pourrez bien sûr modifier ensuite.
5.2 $n_{0 min}$
Lorsque le nombre de résultats est limité par « Max résultats », les suites affichées sont les premières rencontrées par l’algorithme de recherche. Elles ne correspondent donc pas nécessairement aux plus petites valeurs de $n_0$, et le tri par $n_0$ ne porte que sur les résultats effectivement calculés.
Pour trouver $n_{0 min}$ il faut d'abord connaître $t_{max}$ (voir ci-dessus le tableau de la répartition des $n_0$ par type). En l'état actuel des choses c'est impossible pour de grandes valeurs de $L$, le nombre de suites candidates devenant gigantesque bien avant $t_{max}$ , et donc le temps de calcul nécessaire à trouver 0 résultat — ce qui prouverait que la valeur actuelle de $t$ succède à sa valeur maximale — serait prohibitif.
La question du calcul de $t_{max}$ (pas son estimation) reste donc ouverte. En attendant, le calcul de $n_{0\,min}$ est effectué par une recherche exhaustive : les entiers impairs sont testés par ordre croissant à partir de 7, jusqu'à rencontrer le premier (donc le plus petit) dont la suite compressée est de longueur $L$. La recherche est en soi très rapide, mais la valeur de $n_{0\,min}$ , et donc le nombre d'entiers à tester, peut être considérable. Pour lancer cette recherche, saisissez la longueur de la suite puis cliquez sur le bouton $n_{0\,min}$. Il est inutile de renseigner le type. Le bouton "Stop / Reset" permet de stopper le calcul.
5.3 Suites standard vs suites compressées
Entre deux termes impairs successifs d'une suite de Collatz, on peut écrire $ n_{i+1}=\dfrac{3n_i+1}{2^k}$
- Dans une suite compressée, $k$ correspond exactement au nombre d'étapes paires (de divisions par 2) jusqu'au prochain terme impair, puisque $k_{min}=1$. Il faut au minimum une étape pour passer d'un terme impair au suivant.
- Dans une suite standard, $k_{min}=0$, et donc un terme pair est inséré immédiatement après chaque terme impair. Il faut au minimum deux étapes pour passer d'un terme impair au suivant.
- Il en résulte que la longueur – ou nombre total de termes – d'une suite compressée est égale à $\sum k+1$ (le +1 pour $n_0$), tandis que celle d'une suite standard est égale à $\sum k+t+1$. En effet, les $t$ termes impairs intermédiaires ainsi que $n_0$ introduisent chacun une étape paire supplémentaire dans la suite standard.
Conversions
-
$L_c$ → Longueur d'une suite compressée.
$L_s$ → Longueur d'une suite standard.
-
$L_s=L_c+(t+1)$
Exemple : lorsqu'on utilise l'application pour calculer le nombre de suites compressées pour $(L,t)=(33,5)$, en cliquant sur le bouton radio "Standard" on ne parle plus d'une suite standard de longueur 33 et de type 5, mais d'une suite de longueur $33+5+1=39$, toujours de type 5.
Avec ces valeurs de $(L,t)$ on obtiendra un nombre identique de résultats, une liste identique de $n_0$, mais une liste de positions différente car tenant compte d'une plus grande longueur des suites. - $L_c=L_s-(t+1)$
La formule de $n_0$ au début de ce document résulte de l'étude des suites compressées ; elle n'est pas adaptée aux suites standard. La représentation compressée n'est pas seulement un raccourcissement de la suite standard : elle fait apparaître directement la structure algébrique reliant le terme initial $n_0$ à la longueur $L$ ainsi qu'au type $t$ et à la position respective des termes impairs intermédiaires.
Le calcul de $n_0$ utilise toujours les données de longueur et de positions de la suite compressée. Seul l'affichage des résultats introduit une distinction entre les deux modes. Lorsque l'application affiche ceux du mode Standard, elle a d'abord effectué le calcul en mode Compressée puis converti les positions comme l'exemple suivant le montre :
-
Pour $L_c=19$ et $t=4$, la liste de positions $[1,4,7,8]$
devient en mode Standard $[1+1,4+2,7+3,8+4]=[2,6,10,12]$,
et $L_s=19+4+1=24$.
NB : il découle de ce qui précède que la saisie de $L$ et de $t$ ne peut pas être effectuée en mode Standard mais uniquement en mode Compressée. Ensuite, lorsque vous cochez "Standard" la conversion de longueur est calculée et injectée dans le champ "Longueur". Cliquez alors sur Ok pour continuer.
Ouvrir l'application web
12 septembre 2026
Dernière MàJ le 15 octobre 2026