Aide
1. Principe de fonctionnement
Le problème traité ici est un problème « inverse ». Habituellement, on choisit un entier de départ $n_0$ puis on calcule sa suite de Collatz. Ici on fait l'inverse : on fixe d'abord la longueur de la suite et son type, puis on cherche tous les entiers $n_0$ qui possèdent exactement ces caractéristiques.
Dans la version compressée des suites utilisée par l'application, chaque étape est définie par :
Le type $t$ correspond au nombre de termes impairs intermédiaires, c'est-à-dire à l'exclusion du terme initial $n_0$ et du 1 final. Dans ce document, $n_0$ est implicitement impair. Exemples :
Les positions impaires déterminent le terme initial $\mathbf{n_0}$
Prenons une suite compressée de longueur $L$ et de type $t$, dont les termes impairs intermédiaires apparaissent aux positions $p_1 < p_2 < \cdots < p_t$. En développant les transformations successives de Collatz, on obtient :
Autrement dit, une fois connue la position de chacun des $t$ termes impairs intermédiaires de sa suite, $n_0$ est entièrement déterminé. Le problème consiste donc à examiner les différentes combinaisons possibles de positions et à ne conserver que celles pour lesquelles l'expression donne un entier positif. On retiendra que la position de $n_0$, bien que non comptabilisée, est 0.
Pourquoi l'ancienne méthode devenait vite impraticable
Une approche directe consiste à essayer toutes les combinaisons possibles de positions des termes impairs. Leur nombre vaut $\mathbf{\binom{L-5}{t}}$[1], et il peut très rapidement devenir gigantesque, même pour des valeurs de $L$ et $t$ encore modestes. La méthode consistant à tester toutes les combinaisons (suites candidates) fonctionne, mais elle gaspille énormément de temps à développer des branches qui ne pourront jamais conduire à un entier $n_0$. Le plus ennuyeux est que cette méthode finit très facilement par geler le PC qui la met en œuvre.
-
[1]. $\mathbf{\binom{L-5}{t}}$ parce que $n_0$ et les 4 (au minimum)
derniers termes de la suite compressée que sont $8, 4, 2, 1$ ne seront
jamais utilisés comme position pour un terme intermédiaire. Il est donc
parfaitement inutile d'en tenir compte dans la longueur de la suite et
d'augmenter ce faisant le nombre de combinaisons à étudier.
Neuf ans après la création de cette application, une nouvelle méthode proposée par ChatGPT a permis d’optimiser radicalement l’algorithme initial : au lieu d'examiner systématiquement toutes les combinaisons, la nouvelle méthode élimine au fur et à mesure les branches qui ne peuvent pas conduire à une solution.
L'idée clé : éliminer les mauvaises branches avant la fin
La formule précédente impose que son numérateur soit divisible par $3^{t+1}$. Plutôt que d'attendre d'avoir traité tous les ensembles de positions, l'algorithme les construit de la dernière vers la première et teste progressivement des congruences modulo 3, puis 9, 27, 81, etc.
Dès qu'une branche ne satisfait plus la congruence requise, elle est abandonnée. Il est donc inutile d'examiner toutes les positions qui auraient pu la prolonger.
Dans cette relation, $Q_r$ représente la partie déjà construite de la somme correspondant aux $r$ dernières positions impaires :
Le premier filtre, modulo 3, impose déjà une contrainte de parité sur la dernière position. Les filtres suivants deviennent de plus en plus sévères. Le calcul explore donc un arbre, mais en coupe très tôt la plupart des branches impossibles.
Pourquoi le calcul peut être interrompu et repris
L'application exécute la recherche dans un Web Worker afin de ne pas bloquer l'interface. Le parcours de l'arbre est conservé sous forme d'une pile explicite. Lorsque la limite « Max résultats » est atteinte, l'état exact du parcours est mémorisé.
Si l'on augmente ensuite cette limite, la recherche reprend au point précis où elle s'était arrêtée : les résultats déjà trouvés ne sont ni recalculés ni effacés.
Ainsi, une recherche très importante peut être menée par étapes : 1 000 résultats max, puis 10 000, puis 100 000, etc. Lorsque le mot max en rouge disparaît de la mention n suites — dans la barre de titre de la fenêtre de résultats — , l'exploration est exhaustive et le nombre affiché est le nombre réel de suites correspondant au couple $(L,t)$.
2. Utilisation de l'application
Générer la liste (exhaustive ou non) des suites de Collatz — compressées ou standard — dont la longueur et le type sont donnés.
Trouver des $n_0$ dont la suite compressée est de même longueur et type que celle de l'entier $m$ impair
Dans le champ Longueur tapez $m$ précédé d'un #, comme #123. Après validation, l'application le remplacera par la longueur de sa suite et injectera son type dans le champ suivant. Le nombre de suites candidates sera indiqué en rouge en dessous. Validez de nouveau si vous désirez poursuivre.
Bien sûr, $m$ figurera dans la liste finale des $n_0$.
Interactions
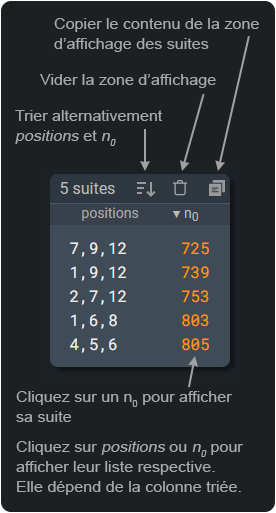
La "zone d'affichage" est le conteneur dans lequel les données demandées s'affichent. Elle se trouve tout en haut de la page du navigateur mais n'apparaît qu'à sa première utilisation.
Sécurité
Pour éviter de vous retrouver avec des dizaines de milliers de résultats que votre navigateur devra gérer et afficher, ce qui risque de devenir probématique si vous disposez de peu de RAM, cochez la case "Nbr de résultats uniquement" avant de cliquer sur Ok. Par exemple, avec $L=65$ et $t=14$ le nombre de suites candidates est de 17 345 898 649 800, et le nombre de résultats de 1 942 132 suites.
Ces chiffres tiennent lieu d'avertissement, n'est-ce pas ? Décochez la case en question avant de cliquer à nouveau sur Ok. Les 100 premiers résultats seulement seront affichés, nombre que vous pourrez bien sûr modifier ensuite.
3. Distribution statistique des suites de Collatz par longueur et type
Pour une longueur $L$ donnée, l'ensemble des termes initiaux $n_0$ peut être réparti selon le type $t$ de leur suite, indiqué dans la colonne de gauche. Le tableau suivant donne cette répartition pour $L=21$ :
| 8 | [43] |
|---|---|
| 7 | [131, 133] |
| 6 | [397, 405, 433, 435, 441, 475] |
| 5 | [1237, 1251, 1285, 1301, 1313, 1325, 1339, 1425, 1427, 1431, 1433] |
| 4 | [3861, 3925, 3939, 3941, 3981, 4017, 4019, 4043, 4277, 4293, 4297, 4301] |
| 3 | [11605, 11829, 12053, 12131, 12133, 12853, 12885, 12893, 12913, 12931] |
| 2 | [36181, 36405, 38677, 38741, 38797, 38833, 38835] |
| 1 | [116053, 116501] |
| 0 | [349525] |
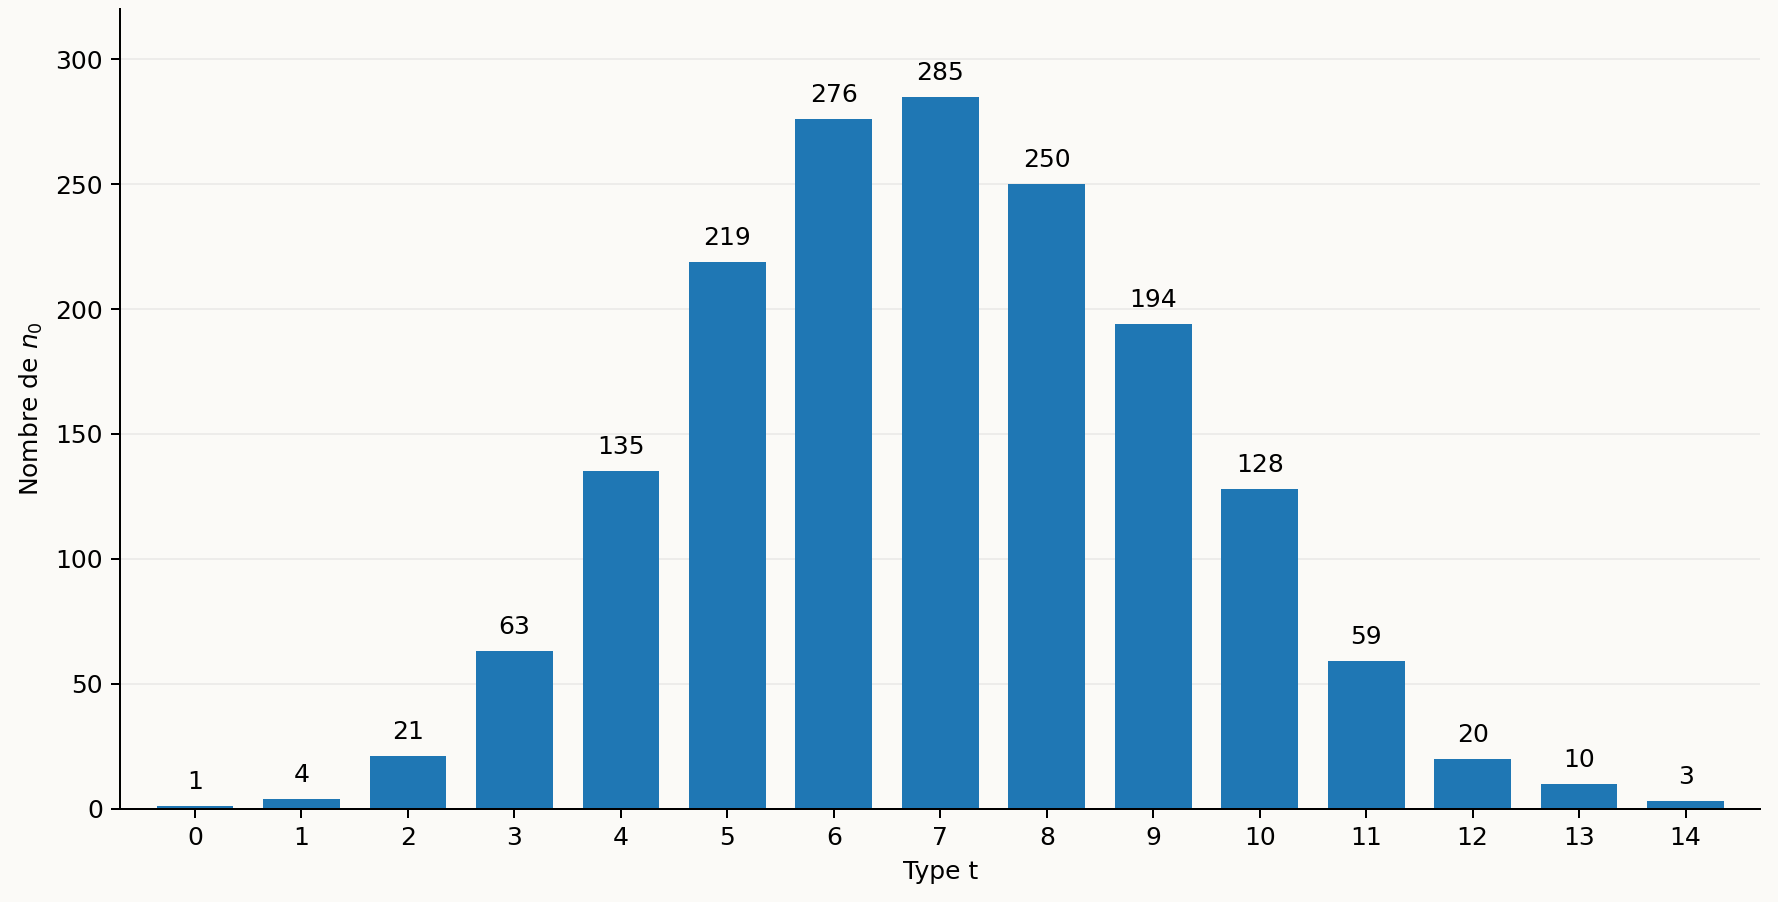
Distribution du nombre de suites compressées pour $L=33$ et $t=0,...,14$
Si l'on ne conserve que le nombre de suites pour chaque type, on obtient une distribution en forme de cloche, qui devient de plus en plus marquée lorsque $L$ augmente :
Valeur respective de $t_{min}$ et $t_{max}$
Si l'on reprend la formule de $n_0$ au début de cette page et qu'on donne à $t$ la valeur 0, on trouve $n_0=\dfrac{2^{L-1}-1}{3}$.
On voit que $n_0$ n'est un entier strictement positif que lorsque $L$ est impair :
Les calculs effectués jusqu’à présent suggèrent que le sommet de la distribution se situe autour de
Cette observation conduit à l’estimation de $t_{max}$ :
4. $n_{0 min}$
Lorsque le nombre de résultats est limité par « Max résultats », les suites affichées sont les premières rencontrées par l’algorithme de recherche. Elles ne correspondent donc pas nécessairement aux plus petites valeurs de $n_0$, et le tri par $n_0$ ne porte que sur les résultats effectivement calculés.
Pour trouver $n_{0 min}$ il faut d'abord connaître $t_{max}$ (voir ci-dessus le tableau de la répartition des $n_0$ par type). En l'état actuel des choses c'est impossible pour de grandes valeurs de $L$, le nombre de suites candidates devenant gigantesque bien avant $t_{max}$ , et donc le temps de calcul nécessaire à trouver 0 résultat — ce qui prouverait que la valeur actuelle de $t$ succède à sa valeur maximale — serait prohibitif.
La question du calcul de $t_{max}$ (pas son estimation) reste donc ouverte.
5. Suites standard vs suites compressées
Entre deux termes impairs successifs d'une suite de Collatz, on peut écrire $ n_{i+1}=\dfrac{3n_i+1}{2^k}$
- Dans une suite compressée, $k$ correspond exactement au nombre d'étapes paires (de divisions par 2) jusqu'au prochain terme impair, puisque $k_{min}=1$. Il faut au minimum une étape pour passer d'un terme impair au suivant.
- Dans une suite standard, $k_{min}=0$, et donc un terme pair est inséré immédiatement après chaque terme impair. Il faut au minimum deux étapes pour passer d'un terme impair au suivant.
- Il en résulte que la longueur – ou nombre total de termes – d'une suite compressée est égale à $\sum k+1$ (le +1 pour $n_0$), tandis que celle d'une suite standard est égale à $\sum k+t+1$. En effet, les $t$ termes impairs intermédiaires ainsi que $n_0$ introduisent chacun une étape paire supplémentaire dans la suite standard.
Conversions
-
$L_c$ → Longueur d'une suite compressée.
$L_s$ → Longueur d'une suite standard.
-
$L_s=L_c+(t+1)$
Exemple : lorsqu'on utilise l'application pour calculer le nombre de suites compressées pour $(L,t)=(33,5)$, en cliquant sur le bouton radio "Standard" on ne parle plus d'une suite standard de longueur 33 et de type 5, mais d'une suite de longueur $33+5+1=39$, toujours de type 5.
Avec ces valeurs de $(L,t)$ on obtiendra un nombre identique de résultats, une liste identique de $n_0$, mais une liste de positions différente car tenant compte d'une plus grande longueur des suites. - $L_c=L_s-(t+1)$
La formule de $n_0$ au début de ce document résulte de l'étude des suites compressées ; elle n'est pas adaptée aux suites standard. La représentation compressée n'est pas seulement un raccourcissement de la suite standard : elle fait apparaître directement la structure algébrique reliant le terme initial $n_0$ à la longueur $L$ ainsi qu'au type $t$ et à la position respective des termes impairs intermédiaires.
Le calcul de $n_0$ utilise toujours les données de longueur et de positions de la suite compressée. Seul l'affichage des résultats introduit une distinction entre les deux modes. Lorsque l'application affiche ceux du mode Standard, elle a d'abord effectué le calcul en mode Compressée puis converti les positions comme l'exemple suivant le montre :
-
Pour $L_c=19$ et $t=4$, la liste de positions $[1,4,7,8]$
devient en mode Standard $[1+1,4+2,7+3,8+4]=[2,6,10,12]$,
et $L_s=19+4+1=24$.
NB : il découle de ce qui précède que la saisie de $L$ et de $t$ ne peut pas être effectuée en mode Standard mais uniquement en mode Compressée. Ensuite, lorsque vous cochez "Standard" la conversion de longueur est calculée et injectée dans le champ "Longueur". Cliquez alors sur Ok pour continuer.
Ouvrir l'application web